먼저 결론
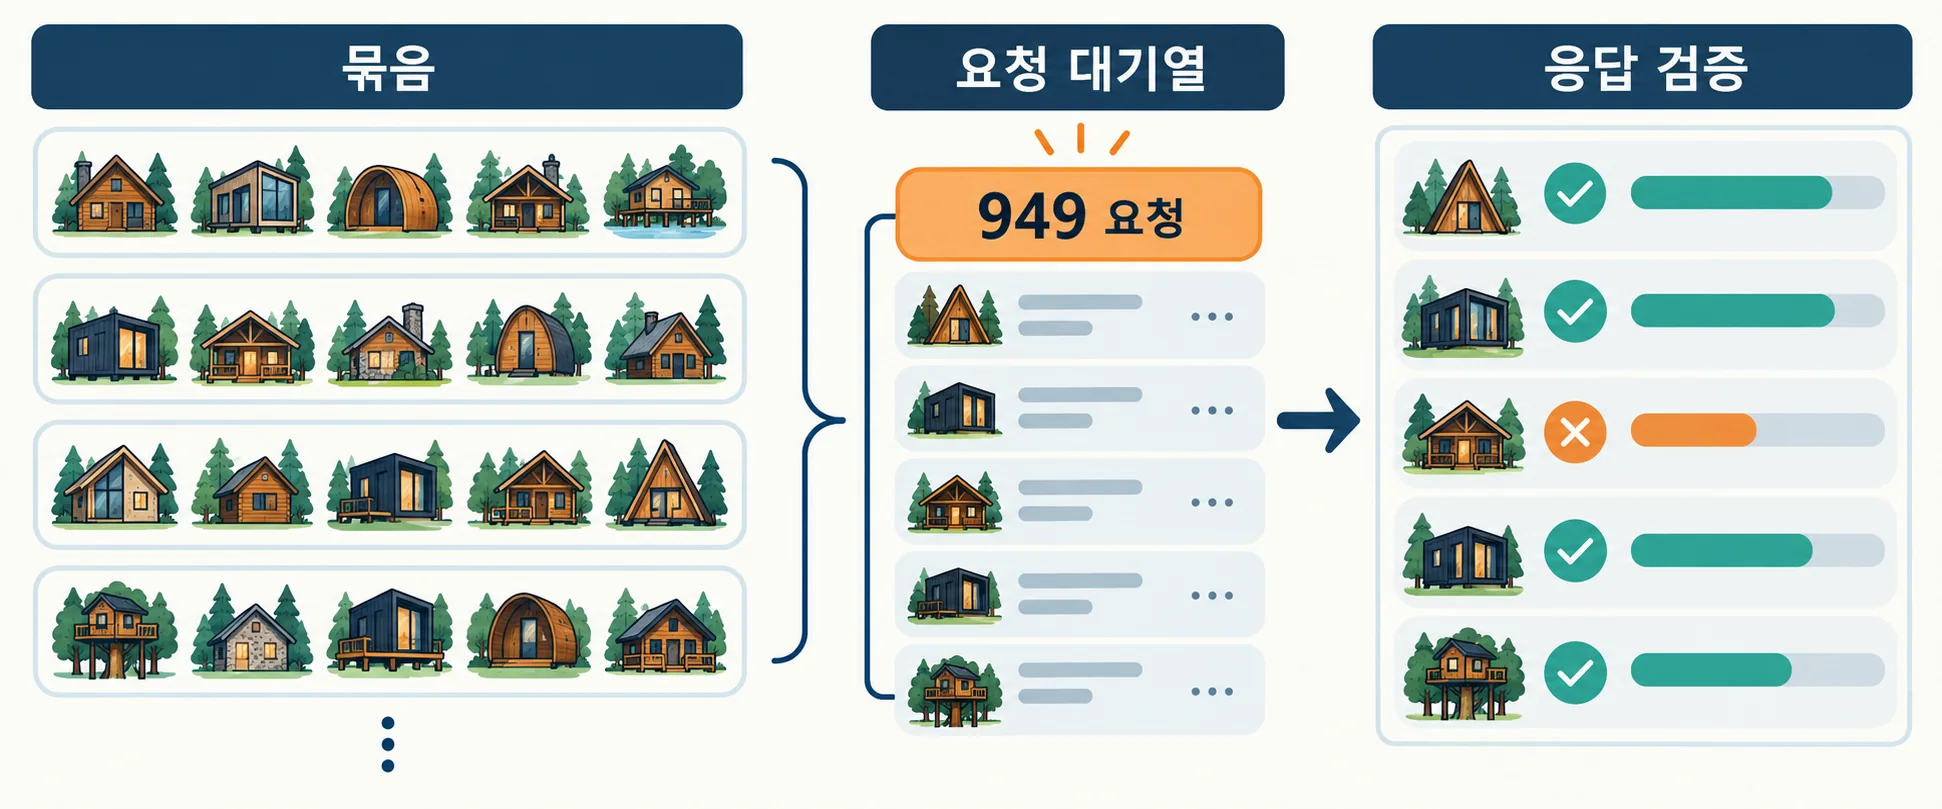
숲나들e 빈자리 수집에서 949회 요청을 더 빨리 보내는 것보다, 필요한 데이터를 빠짐없이 받는지 확인하는 일이 먼저였다. 한 번의 수집이 다음 주기와 겹치지 않도록 하고, 요청 수·성공 수·실패 수를 같이 기록해야 병목이 보인다.
휴양림 빈자리를 한 화면에 모으는 앱을 만들면서 숫자 하나가 눈에 걸렸다. 전국 휴양림 186개를 대상으로 돌리던 당시, 한 사이클에 API 요청이 약 949회였다. 처음에는 “동시 요청 수만 높이면 금방 끝나겠지?” 싶었다. 컴퓨터에게 일을 열 개씩 시키면 두 개씩 시킬 때보다 다섯 배 빠를 거라는, 꽤 인간적인 계산이다.
하지만 수집기는 계산기처럼 움직이지 않았다. 내 코드의 실행 속도뿐 아니라 네트워크 지연, 응답 크기, 상대 서버의 처리 상황이 모두 걸려 있었다.
브라우저 요청을 먼저 관찰했다
사이트가 한 달치 숙소 정보를 조회할 때 보내는 요청을 살펴보니 goodsIdList에 여러 숙소 ID가 들어갔다. 당시에는 5개씩 묶인 요청을 기준으로 수집했다.
여기서 “10개를 한 번에 넣으면 요청 수가 반으로 줄겠네”라고 생각하기 쉽다. 그런데 주소나 매개변수가 10개를 받아들인다고 해서 응답에도 10개 결과가 온다는 보장은 없다. 요청한 ID 목록과 응답에 실제 포함된 ID·건수를 대조해야 한다. 값이 비어 있거나 일부만 돌아오면, 빠른 수집이 아니라 조용한 누락이다.
그래서 묶음 크기를 바꿔 시험할 때는 총 요청 수만 보지 않았다. 요청한 대상 수, 응답한 대상 수, 실패 수를 함께 확인했다.
동시성은 속도 조절 손잡이일 뿐
동시 요청을 2개, 5개, 10개로 올려보며 전체 소요 시간을 봤다. 동시성이 커질수록 항상 비례해서 빨라지지는 않았다. 응답 대기 시간이 겹치는 이점은 있지만, 너무 많이 몰아 보내면 실패·재시도와 상대 서버 부담이 늘 수 있다.
기록할 때는 이런 네 가지를 한 세트로 남기는 편이 좋았다.
- 시작·종료 시각과 총 소요 시간
- 요청 수와 대상 숙소 수
- 성공·실패·누락된 응답 수
- 재시도 여부와 HTTP 상태
“2분 만에 끝났다”만 적어두면 다음 날 3분이 걸렸을 때 원인을 찾기 어렵다. 반대로 숫자를 같이 남기면 네트워크 지연인지, 요청 대상이 늘었는지, 실패가 쌓였는지 구분할 수 있다.
다음 수집과 겹치지 않게
수집 주기를 2분으로 정했더라도 한 사이클이 2분을 넘을 수 있다. 그 상태에서 타이머가 다음 사이클을 무조건 시작하면, 느려진 수집 위에 새 수집이 겹친다. 병목에 가속 페달을 밟는 셈이다.
내가 선택한 방향은 현재 사이클이 끝나기 전에는 다음 사이클을 시작하지 않는 것이었다. 늦어졌다는 사실은 상태와 로그에 남기고, 운영자가 실제 완료 시간을 볼 수 있게 했다.
결론
이번 949회는 당시 대상과 구현에서 나온 관찰값이다. 지금도 같은 요청 수라는 뜻은 아니다. 수집 성능을 볼 때는 요청을 얼마나 빨리 던졌는지보다 얼마나 정확하게, 무리 없이 끝냈는지를 같이 봐야 한다.